
Scrutiny 将硬盘 S.M.A.R.T. 数据、温度和历史趋势整理成网页面板,并支持异常通知。适合管理多块硬盘的家庭服务器和 NAS,部署前需要确认 smartctl 能读取设备,以及容器具备正确的设备映射和权限。
资源档案
- 支持平台
- Web / Docker / Linux
- 收费方式
- 开源免费,自托管需承担服务器与数据存储成本
- 开源协议
- MIT
- 收录时间
- 2026-11-01 10:30:00
家里的 NAS 或服务器装了多块硬盘后,逐块查看温度和健康信息会越来越费事。 偶尔打开一次检测工具,也很难记住某个属性在过去几周有没有持续变化。 Scrutiny 把硬盘健康数据整理成网页面板,保存 S.M.A.R.T. 指标的历史趋势,并在满足条件时发送异常提醒。
它适合想持续观察磁盘状态的自托管用户,尤其是已经运行 Docker、需要管理多块物理硬盘的环境。 能否正常使用,关键在于底层工具是否读得到硬盘信息,以及采集程序是否拥有访问设备的权限。
让硬盘状态有连续记录
官方项目说明把 Scrutiny 定位为硬盘健康监控面板。 它结合厂商提供的 S.M.A.R.T. 指标和现实故障率资料,展示需要关注的数据,并支持温度跟踪、历史趋势和通知。
S.M.A.R.T. 是硬盘提供的一组自我监测信息。 对使用者来说,历史记录的价值在于能够对照某项数据的变化,而不仅是查看打开页面那一刻的状态。 例如,硬盘出现异常提醒时,可以结合温度走势、相关属性和采集时间,判断需要继续检查哪些设备。
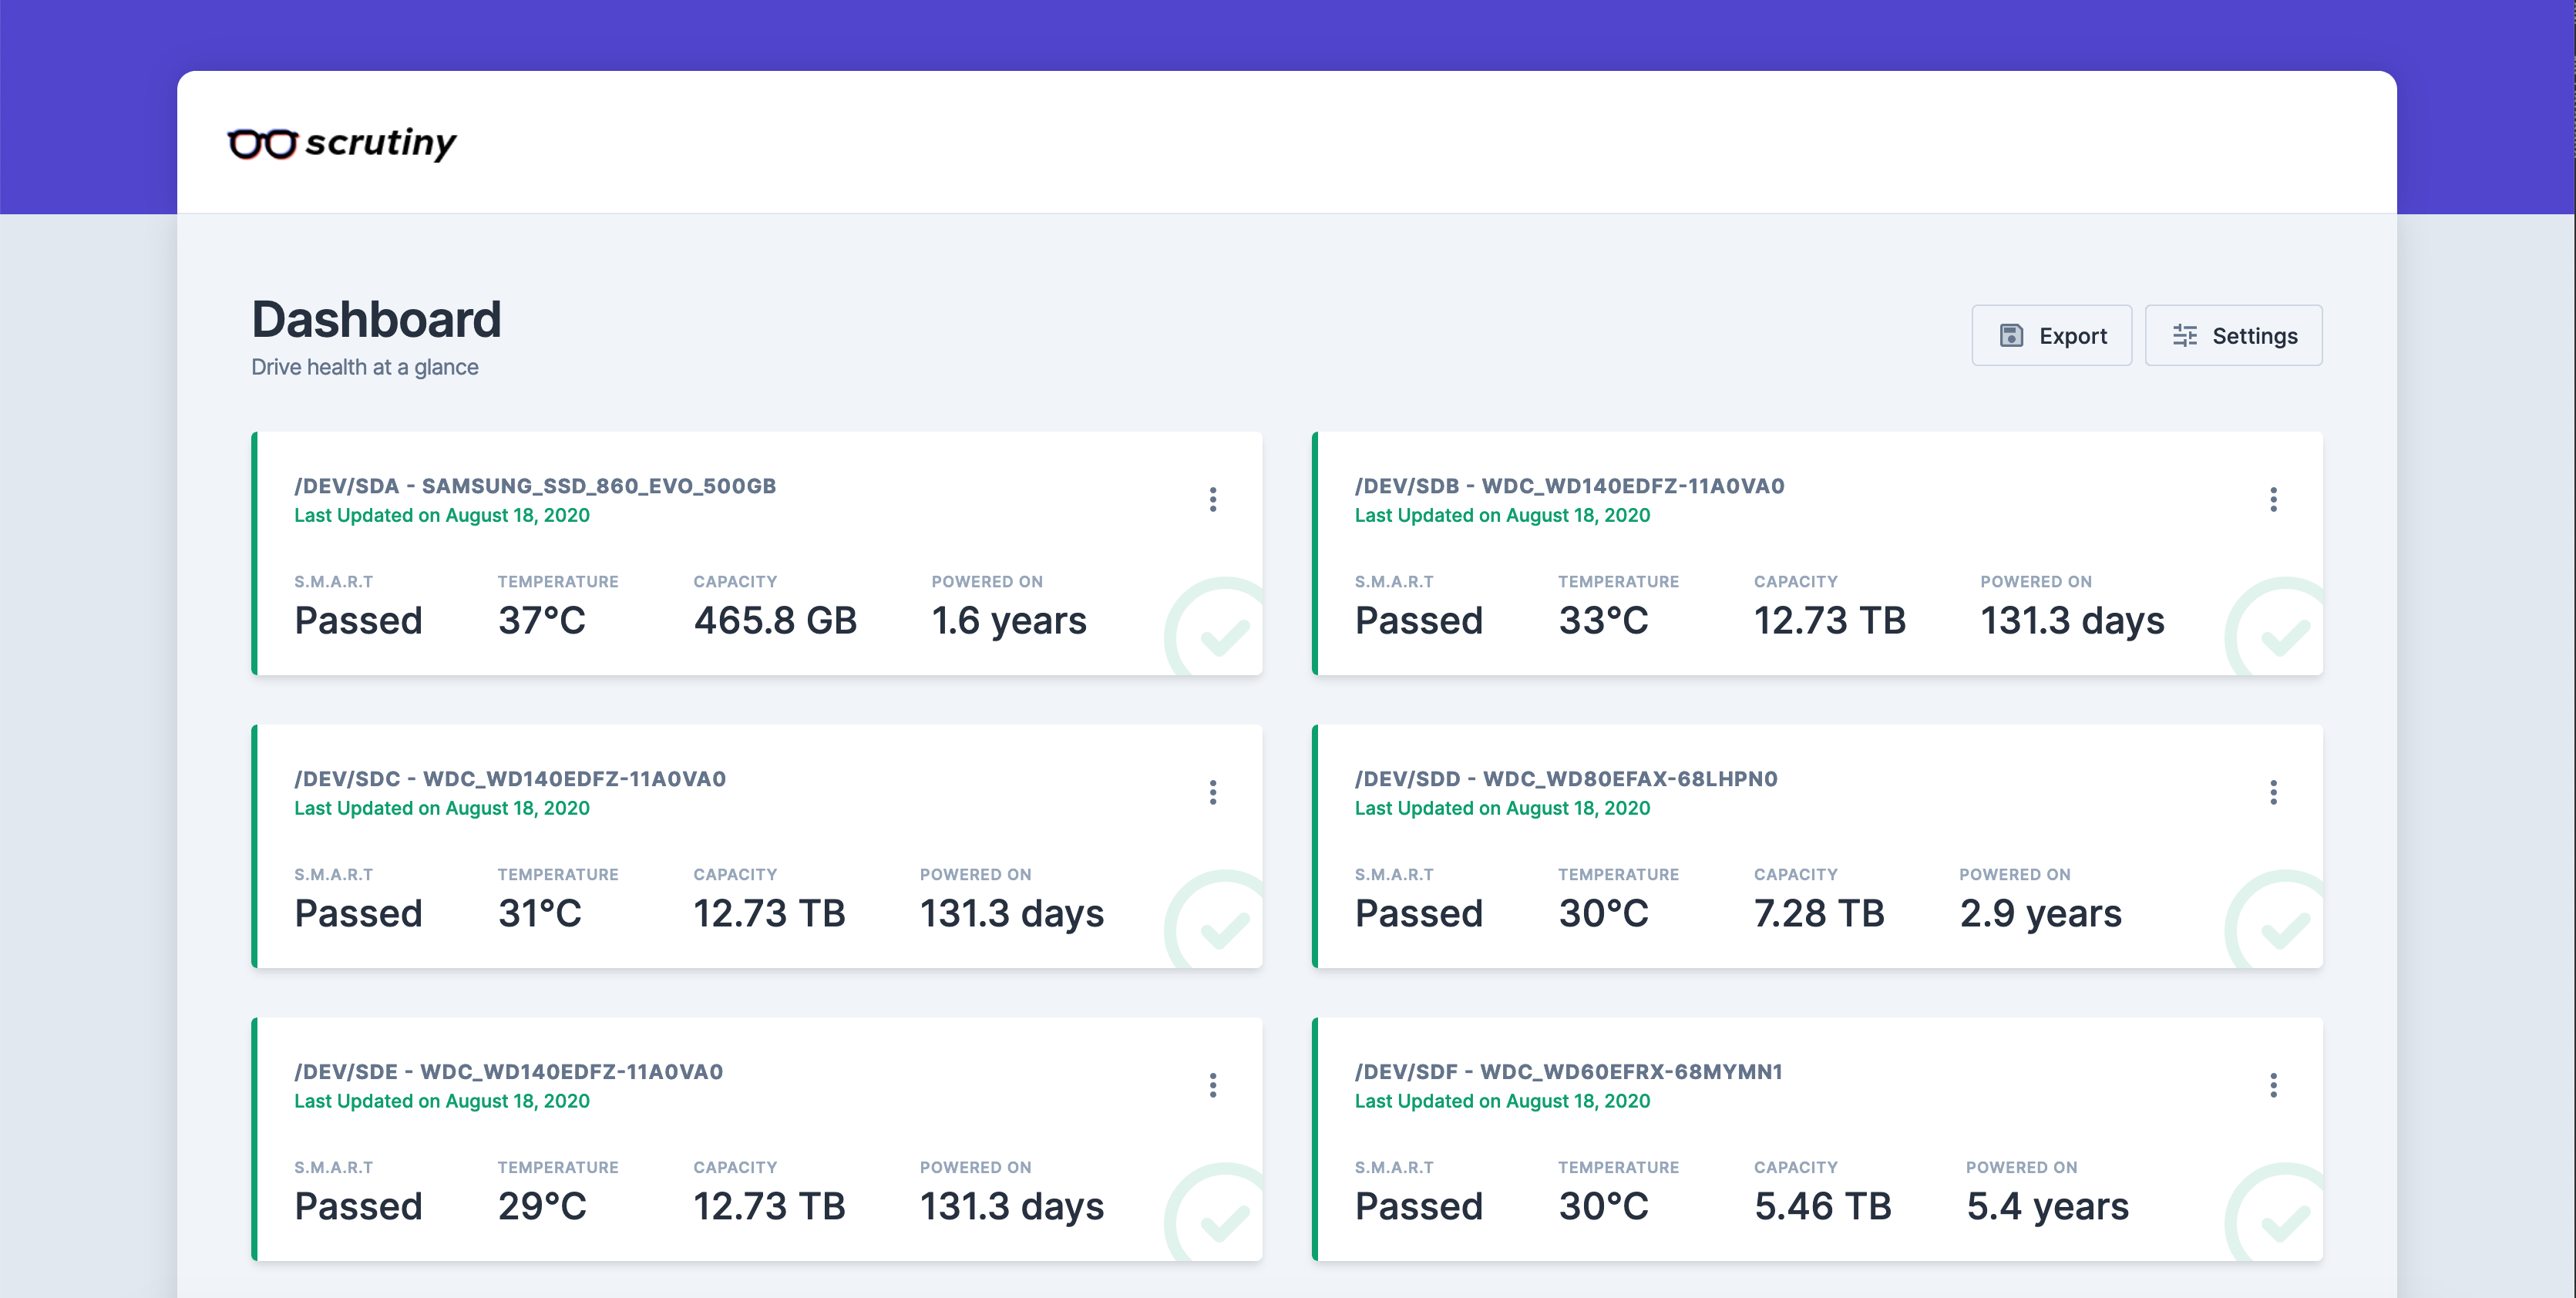
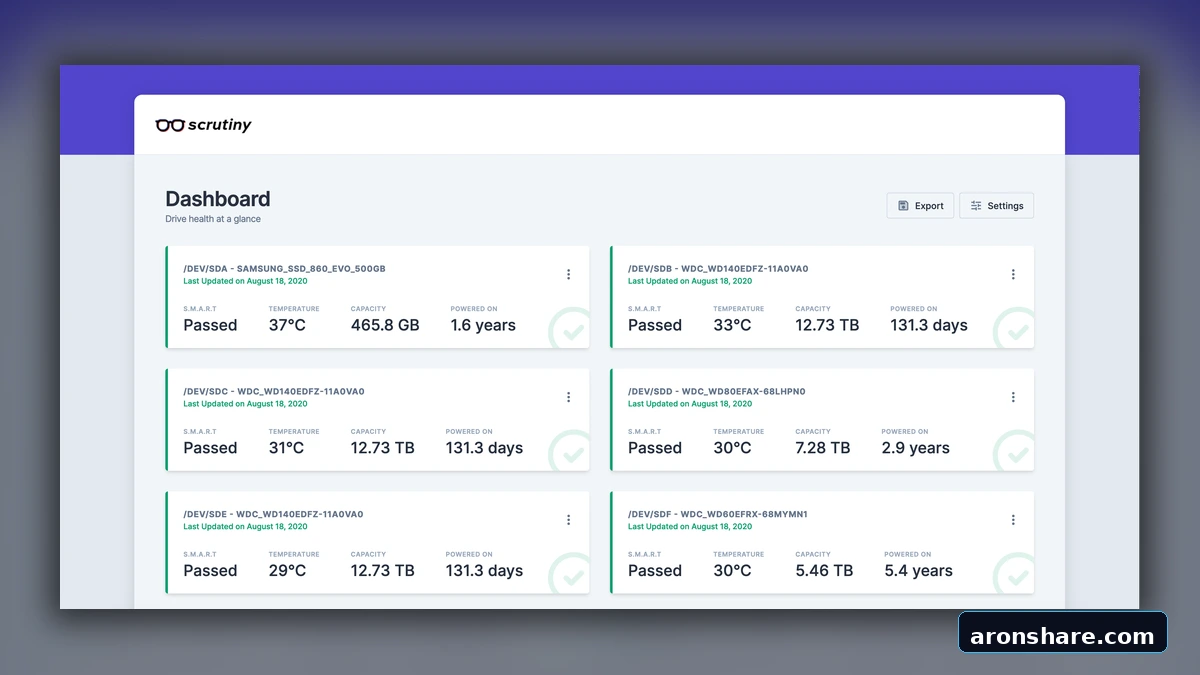
图为官方 README 沿用的历史界面示例,页面显示的采集日期为 2020 年 8 月 18 日。 每块硬盘的卡片展示健康状态、温度、容量和通电时长,便于快速浏览多块设备。
健康监控能够提供检查线索,重要数据仍应保留独立备份,并定期验证恢复流程。 收到异常提醒后,可以结合备份状态、设备日志和厂商诊断工具安排进一步检查。
部署前确认硬盘信息能被读取
Scrutiny 使用 smartctl --scan 检测设备。
官方设备排障文档建议在宿主机检查检测结果,确认目标硬盘可见,再对照容器内的结果定位配置问题。
这里尤其需要留意 RAID 控制器、虚拟磁盘和 NVMe 设备。
部分 RAID 控制器能够传递底层 S.M.A.R.T. 信息,另一些则需要额外配置或无法提供完整数据;设备类型识别不准确时,可以通过 collector.yaml 调整。
云服务器提供的虚拟磁盘是否暴露这些信息,也需要按实际环境确认。
使用 Docker 时,需要将目标设备显式传入容器,并按官方示例挂载 /run/udev,供采集器读取设备元数据。
官方文档要求 SYS_RAWIO 权限;NVMe 场景还需要 SYS_ADMIN,并应关注控制器设备与存储命名空间的区别,例如 /dev/nvme0 与 /dev/nvme0n1。
这些权限涉及主机设备访问,应只授予可信的官方镜像,并限制管理界面的网络访问范围。 不要为了让页面出现数据就盲目放开全部设备或扩大容器权限。
一台机器可以使用整合镜像
Scrutiny 提供包含网页服务、API 和采集器的 Omnibus 部署方式,适合把监控服务与硬盘放在同一台机器上的情况。 官方 Compose 示例展示了配置目录、InfluxDB 数据目录、设备映射和所需权限。
使用示例时,需要把 /dev/sda、/dev/sdb 等设备路径改成实际设备,并为配置及历史数据设置持久存储。
示例文件中的镜像标签可能指向开发构建,日常使用可以参照发行页面固定到明确版本,避免自动跟随浮动标签带来的变化。
网页服务的官方默认访问示例是 http://localhost:8080。
数据库管理端口与网页端口用途不同,部署时只开放自己需要访问的入口,远程管理可通过受控内网或带访问控制的代理进行。
对于分散在多台服务器上的硬盘,还可以使用 Hub/Spoke 方式:各台服务器运行 Collector,集中部署网页服务和 InfluxDB。 这样无需把每台机器的界面单独打开,但需要正确配置采集器上传地址和网络连通性。
看得到硬盘,也要确认数据持续更新
网页服务启动后,面板需要收到一次采集结果才会显示硬盘数据。 官方说明中的 Omnibus 镜像会运行采集任务;分离部署或手动安装时,需要确认 Collector 已经执行。 排查时可以用官方给出的命令触发采集,容器名称应与自己的配置一致:
docker exec scrutiny /opt/scrutiny/bin/scrutiny-collector-metrics run官方容器默认每天执行一次采集,也支持通过 COLLECTOR_CRON_SCHEDULE 调整计划。
具体采集频率应结合使用需求和设备特性设置,并检查页面上的更新时间,确认记录持续增加。
通知支持邮件、Webhook、ntfy、Telegram 等渠道,配置示例位于仓库的 example.scrutiny.yaml。
完成通知配置后,可以调用官方提供的健康检查接口发送测试通知:
curl -X POST http://localhost:8080/api/health/notify这条命令用于检查通知通道是否配置正确。 实际部署中,还需要观察正常采集是否继续进行,以及硬盘异常时使用的通知规则是否符合自己的处理习惯。
适合把硬盘检查变成日常维护
Scrutiny 采用 MIT 许可证,开源软件本身无需购买许可,自托管的计算资源、历史数据存储和维护由使用者承担。 项目 README 仍提示有待完善的部分,部署时应保留配置与数据备份,并阅读所用版本的说明。
它最适合解决的任务,是持续记录多块硬盘的健康信息、集中查看趋势和接收提醒。 如果你正在为家庭服务器补上这项日常维护,可以选一块能够正常读取 S.M.A.R.T. 信息的设备接入,检查设备识别、采集更新时间和测试通知,再扩大到其余硬盘。
官方入口
获取渠道
均为官方或作者公开渠道,下载安装前请留意系统版本与权限提示。
相关资源
 开源自托管
Trilium Notes 让一份笔记同时出现在多个知识目录里
Trilium Notes 支持树状笔记、同一笔记多处引用、全文搜索与修订记录,适合整理长期积累的学习和项目资料。桌面端可离线使用,多设备同步需要服务器,定位为单人知识库。
 开源自托管
Actual Budget 帮你把账户流水整理成看得懂的日常预算
Actual Budget 是本地优先的开源预算工具,支持文件导入、支出分类、多设备同步和可选端到端加密。可自托管或使用付费托管,银行同步另有服务与地区条件。
 开源自托管
Uptime Kuma 帮你持续检查网站是否在线并在异常时发出通知
Uptime Kuma 支持网站、端口、DNS 和 Docker 容器等监控,可连接通知服务并建立状态页。适合自建网站与家庭服务,部署时要注意数据卷、网络位置和反向代理设置。
 开源自托管
Penpot 让设计师和开发者围绕同一份界面稿讨论布局与交互
Penpot 是支持浏览器使用与自托管的开源界面设计工具,提供 Flex 和 Grid 布局、交互原型、组件及 Inspect 检查模式。适合设计师和开发者共同维护页面设计,企业管理功能有单独的付费方案。